- 作者:本站
- 发表时间:2026-10-21 浏览次数:7
安卓手机群控的稳定性,本质上不是靠某一款“神器”撑起来的,而是硬件一致性、调度架构、网络链路、脚本健壮性和运维监控这五个层面共同咬合的结果,任何一层出现短板,数量一上去就会原形毕露——掉线、卡顿、指令错乱、设备假死,都是链条上某一环松动的信号,把稳定性寄托在单一工具的功能列表上,是实践中踩过多的坑。
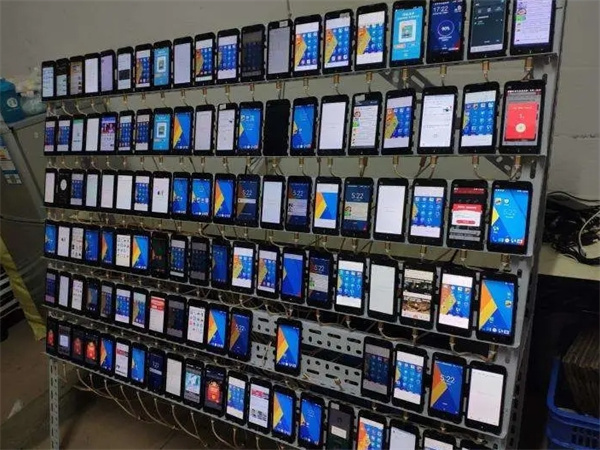
1、硬件与系统底层的“干净度”决定下限
设备本身的状态,是群控稳定性的道闸门,同一批次、同型号、同系统版本的机器,在指令响应延迟上的离散度明显更小,实际操作中,混用不同品牌、不同安卓版本的设备,往往会让群控端在分发任务时出现兼容性抖动,尤其是涉及输入法注入、悬浮窗权限、后台保活策略这些环节,系统差异会被放大成肉眼可见的不稳定。
更隐蔽的问题是系统“脏”——预装软件残留、电池优化策略被改过、开发者选项里的动画缩放被调乱,这些都会让自动化脚本的时序假设失效。
有经验的团队会在入控前做一轮标准化:统一刷入同版本固件、关闭不必要的系统服务、固定屏幕刷新率与动画参数、锁定后台进程白名单,这一步做得越扎实,后面调度层要处理的异常就越少。
2、调度架构要能扛住“部分失败”
群控系统天然是分布式场景,几十上百台设备同时在线,个别设备掉线、响应超时、指令回执丢失是常态而非意外,稳定的调度架构,核心设计原则是“假设失败一定会发生”:指令下发走异步队列而非同步阻塞,每台设备有独立的心跳通道和超时判定,任务重试带退避策略而不是无脑重发。
更细一点说,调度端要能区分“设备离线”和“设备在线但脚本卡死”这两种状态,前者靠长连接心跳判断,后者要靠脚本层定期上报执行进度。
很多群控方案在设备数量少时表现尚可,一上规模就乱,问题往往出在调度器把“全部成功”当成默认预期,一旦某台设备回执慢,整个批次的任务状态就跟着错乱,把部分失败当成设计输入,而不是异常分支,稳定性才有底座。
3、网络链路与连接管理是隐形战场
群控的指令通道对网络抖动其敏感,尤其是无线环境下,AP负载、信道干扰、DHCP租期这些因素都会让长连接悄悄断开,稳定的做法不是单纯依赖TCP长连接,而是在应用层维护一套轻量心跳加断线重连机制,重连时带上设备标识做会话恢复,避免指令重复执行。
另外,设备侧的Wi-Fi策略要固定:关闭省电模式下的Wi-Fi休眠、固定IP或做静态DHCP绑定、群控网关与设备尽量在同一子网内减少跳数,如果设备规模再大一点,还要考虑把指令通道和数据回传通道分开,避免大文件回传把控制信令挤掉,这些细节听起来琐碎,但实际运维中,相当比例的“群控不稳”后追下去都是网络层的小毛病。
4、脚本健壮性比功能丰富更重要
自动化脚本是群控真正干活的部分,也是容易引入不确定性的地方,稳定的脚本设计有几个共同特征:每一步操作都有明确的等待条件而不是固定sleep,界面元素定位用多重兜底(文本、ID、坐标按优先级降级),关键步骤执行后做状态校验再进入下一步,异常分支有截图和日志落盘。
更细的层面,脚本要能识别“当前页面不是预期页面”这种情况并主动回退到已知状态,而不是硬着头皮往下点,实践中,脚本层面的稳定性提升往往比换一套群控工具更立竿见影——因为大部分指令错乱和设备假死,根源是脚本在页面加载未完成时就发出了下一步操作。
5、运维监控要能提前闻到味道
群控系统跑起来之后,稳定性保障的重心就从“搭建”转向“观测”,需要盯的指标不是简单的在线数量,而是设备心跳延迟的分布、单条指令从下发到回执的耗时P95值、脚本执行失败率的滚动窗口、设备温度与内存占用的趋势,这些指标一旦出现漂移,往往比设备真正掉线早几十分钟甚至几小时给出信号。
成熟的运维做法是给每台设备打上健康分,低于阈值自动隔离并触发重连或重启流程,而不是等操作人员发现某台机器“不动了”再去手动处理,另外,日志要能按设备、按任务、按时间三个维度快速检索,否则排查一次偶发失败的时间成本会高到让人放弃追根因。
说到底,手机群控的稳定性是个系统工程,没有哪一层可以单独兜底,硬件标准化降低方差,调度架构消化部分失败,网络层守住连接生命线,脚本层把不确定性关进笼子,运维层提前发现漂移——五件事都做到及格线以上,规模上去之后才不会天天救火。