- 作者:本站
- 发表时间:2026-11-10 浏览次数:2
我的判断很直接:稳定的安卓群控系统是提高工作效率的关键,只有把稳定性做成可度量、可运维、可恢复的能力,群控才值得规模化使用,倒过来说,先定稳定性指标,再谈并发和自动化,顺序不能反。
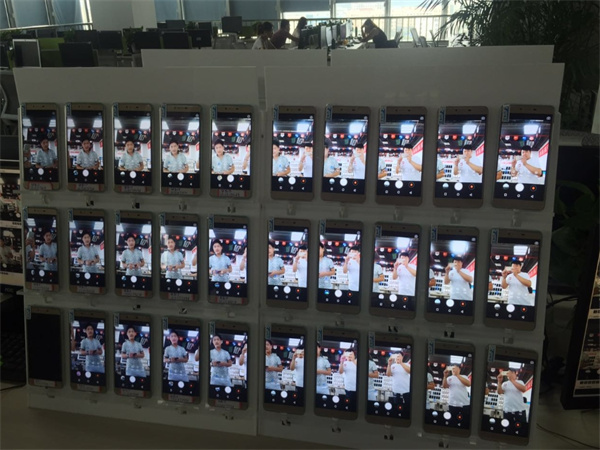
一、设备侧先做“基线统一”,稳定性才有地基
设备不一致、供电散热和系统策略不统一,后面所有软件优化都会被抵消,先做设备基线,再谈群控效率;实际运维里,容易被忽略的是设备本身,型号混杂、系统版本不同、分辨率不一致,脚本在一台机器上能跑,换一台就卡在权限弹窗;电池鼓包、USB供电不足、散热差,会让设备在高峰期集体掉线。
更隐蔽的是厂商省电策略和自动休眠,表面在线,任务却停在后台,我的做法是先定一条设备基线:系统版本、开发者选项、自动休眠、权限授予、分辨率与字体尽量统一;新设备先做电池健康和供电抽检,再小批量跑72小时,观察掉线、重启和任务失败分布。
别一上来铺几百台,先拿20台做“压力样本”,把问题暴露在低成本阶段,设备分组也要按用途和稳定性标签来分,不要只按编号,基线统一后,很多所谓“系统不稳”其实会消失一半。
二、连接层按“会断”设计,断线重连才不会拖垮效率
连接层不能假设永不断线,要把断线、重连、超时当成常态来设计,连接稳定性靠的是限流、退避和
可观测,而不是一根好线;USB集线器供电不足、线材老化、端口映射混乱,都是群控掉线的常见来源;无线连接还要面对网络抖动和IP冲突。
更麻烦的是“重连风暴”:一批设备同时断开又同时重连,把管理端和网络打满,后变成大面积超时,比较稳妥的做法是给连接层加心跳和超时分级,重连采用指数退避并加随机抖动,限制单位时间重连数量;连接池要记录每台设备的后在线时间、失败次数和恢复耗时。
别把所有设备塞到一个Hub上,供电和端口要留余量,日志里要能看出是线材问题、网络问题还是设备休眠,否则每次故障都靠猜,连接层做扎实,任务调度才有意义。
三、任务调度要能失败隔离,脚本健壮性比并发数字更重要
真实产出取决于任务队列的幂等、重试上限和失败隔离,脚本健壮性比并发数字更重要,并发拉满但失败不可控,效率是负数;很多团队喜欢看“同时控制多少台”,却忽略任务状态机。
一个任务下发后,是等待、执行、成功、失败还是超时,必须有明确状态;重试要有上限,失败设备要自动隔离,不能反复卡在同一台机器上拖累整批,脚本层面,少用固定等待,多用元素出现和页面稳定判断;异常时自动截图、保留日志,方便复盘。
任务队列要支持优先级和分批灰度,先小批量验证再放量,并发不是越高越好,管理端、网络和设备负载都有边界,找到稳定吞吐量比追求峰值更划算,人工兜底也要预留,比如失败任务进入待处理池,而不是无限重试。把这些做细,效率才是可持续的。
四、监控告警和运维流程,是稳定性的后半场
没有监控和流程,群控就是黑盒;稳定性后半场靠指标、告警降噪和复盘,能提前发现异常,比事后重启更省时间。
监控至少要看设备在线率、任务成功率、平均恢复时间、失败原因分布和连接重连次数,告警要降噪,别让每条掉线都打电话,按批次和持续时间设阈值;否则值班人员很快会麻木,变更要有窗口,升级管理端、换Hub、调网络都算变更,先灰度再全量。
日志留存和审计要够用,出问题能定位到设备、任务和时间段,运维流程上,备件、远程重启、设备替换、周报复盘都要形成SOP,稳定不是靠某个“神器”,而是靠这些看起来琐碎的动作,把故障控制在可恢复范围内。
五、选型看长期成本,用实测和演练替代功能清单
选型别只看功能清单,要看长期运维成本、可恢复性和升级兼容,实测和故障演练比演示更能说明问题;评估一套系统时,我会看它断网后能否自动恢复、升级是否兼容旧设备、权限能否隔离、日志是否完整、厂商支持是否跟得上。
功能演示很容易好看,真正要测的是并发压测、断网演练和故障注入:拔掉几台设备、模拟网络抖动、让任务失败,观察系统是否可控,合规使用也要提前确认,设备授权、数据隔离和操作边界不能含糊。
把培训、SOP和备件成本算进总拥有成本,再决定是否规模化,稳定的安卓群控系统不是买来就稳,而是选对底座、做细运维、持续复盘之后,才真正成为提高工作效率的关键。